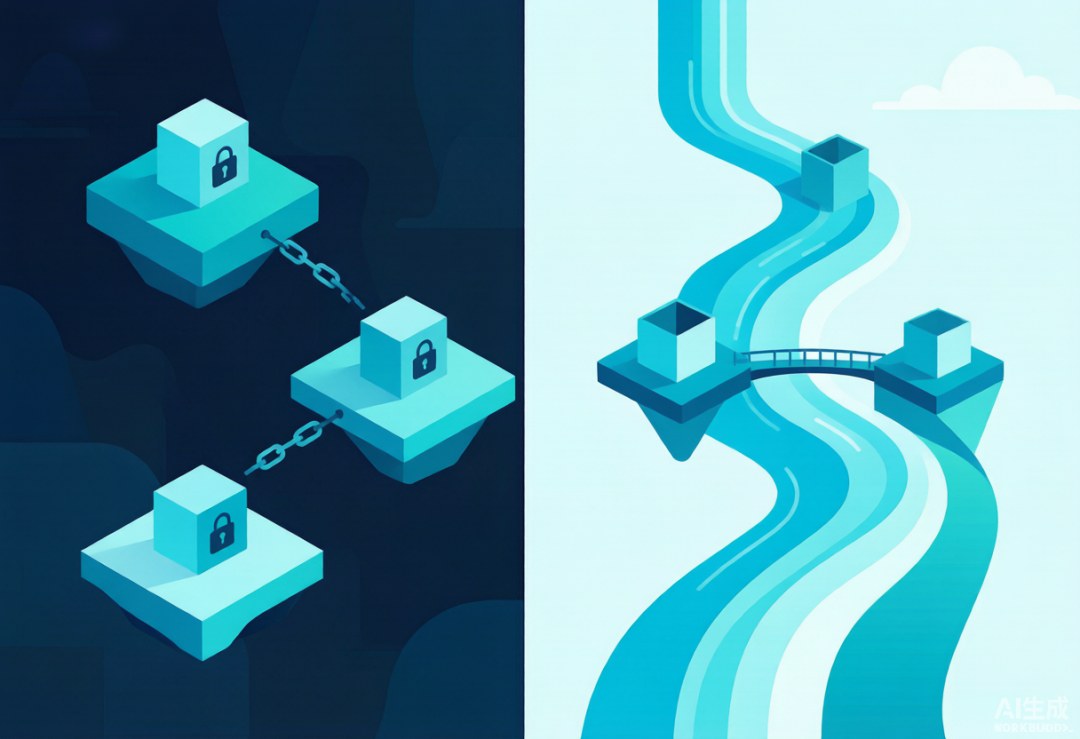
某头部券商每年在多家媒体上投放开户与入金引导,预算以亿计;某头部车企的线索来自搜索、信息流、垂直媒体、门店活动十几条来源;某教育机构更是同时跑着短视频、社群、直播、地推好几条获客管道。它们共同卡在一个点上:每个渠道各自记一本账,到了月底谁也说不清,新增的开户、到店、试听,到底是被哪一次触达种下的。单看一次投放,数据能讲清当次;可把这几次投放放在一起比,规律就糊了。行业大部分同行的普遍做法,是把各家的报表拼一拼就交差,从不把链路真正接成一本总账。于是 AI 拿到的是一堆彼此割裂的碎片,算得再花哨,地基也是松的。我们见过十几家同类广告主,漏点都集中在前后链没接齐这道门——这不是模型不行,是喂模型的食材没备齐。
① 数据底座最迷人的地方,是越接越多之后,喂给 AI 的它自己会越算越准。
把数据底座想成一个会越用越聪明的账本,就明白这句话在说什么。AI 要学得准,前提是喂给它的每一条样本都带着完整因果:用户先看了什么、又点了什么、最后在哪转化。当只接了信息流一家,模型看到的永远是一半的剧本,它只能就着残缺的片段硬编规律,今天觉得这条素材好,明天换了人群又失灵。行业大部分同行的普遍做法,是接一家算一家,宁可让模型在半本账上瞎练,也不愿花力气把链路打通。
反过来,每多接一条链路,模型手里就多一类真实剧本。某头部券商把品牌词搜索、效果广告、APP 内行为接进同一本账后,模型第一次能区分用户是冲着你来还是被广告拉来,对开户意向的预测精度肉眼可见地上了一个台阶。某头部车企接齐搜索、到店、试驾之后,原本分散在四五个系统里的用户轨迹合成了一条线,AI 不再猜这个人会不会买,而是能说清卡在试驾前哪一步。复利就藏在这里:接得越多,模型见过的真实因果越全,下一次判断需要的试探越少,算得越快也越便宜。
更关键的是,这种复利是站在实地上长的。单点投放的数据只能回答这条广告当次有没有效,底座数据却能回答哪一类人、走哪条路径、最容易转化。当 AI 脚下踩的是一本接齐的总账,它的每一次输出都踩在事实而不是假设上。我们见过行业大部分同行的普遍做法,是追求模型参数多大、算法多新,却不肯先把手里的账接平——结果模型越炫,离真实业务越远。数据底座的复利,恰恰是把这股劲儿反过来:先备齐食材,AI 自然越算越准,而且越用越省。
② 单点数据看的是一次投放,底座数据看的是一类规律——模型越嚼越有味,归因越跑越便宜。
单点数据和底座数据的差别,一句话说清:前者记的是这一回,后者记的是这一类。一次投放的数据,只能告诉你这条素材今天花了多少、带回多少点击;底座数据把几百次投放、几十条链路叠在一起,模型嚼的是共性,不是个例。
对跨媒体年投的客户,这个差别直接变成钱。行业大部分同行的普遍做法,是每次开新渠道都重新搭一套统计、重新付一遍建模的算力,因为旧数据和新渠道接不上,经验传不过来。底座数据反过来,新链路一接进来,模型拿着过去积累的一类规律直接套,初始化就站在高处,不用从零摸索;归因跑一趟的成本,被前面的积累摊薄了。某教育机构把短视频、直播、社群、地推全接进底座后,新开一个获客渠道,归因模型两天就能给出版本,而行业普遍要花两三周从头调。
更妙的是越嚼越有味。单点数据看一次就废了,下个月又是一片空白;底座数据是被反复咀嚼的,模型每跑一次都在旧规律上叠加新观察,对哪类人走哪条路转化的理解越来越细。这带来一个反直觉的结果:AI 越强,单位归因越便宜,因为它靠的是沉淀,不是重复烧钱。我们和客户共建时最较真的一件事,就是别让每条链路各自为战——接成一本总账,模型才嚼得出味,归因才跑得起量。对券商、车企这种链路又长又杂的客户,这省下的不是一点半点。
③ 对跨媒体年投客户,每多接一条链路,AI 下一次归因就少一分瞎猜,复利肉眼可见。
跨媒体年投的客户,最容易被瞎猜吃掉预算。它们在搜索、信息流、垂直媒体、门店活动上同时撒网,可只要有一条链路没接进底座,AI 在判断这笔转化该记谁时就是半蒙的。少一条链路,模型就少一块拼图,归因结果里那块空白只能靠默认规则硬填,填出来的往往就是错的。
某头部车企一年在十几条来源上投线索,早年只接了效果广告和到店数据,品牌内容、车展、老带新全在账外。结果 AI 每次归因都把功劳算到效果广告头上,车展带来的意向、老客户带来的转介绍,系统连看都不看。行业大部分同行的普遍做法,是把没接进来的部分当成自然流量一笔勾销,看似省事,实则是让 AI 在瞎猜的基础上继续瞎猜。每多接一条链路,这种瞎猜就少一分:接上车展,模型才知道车展带来的意向最后在到店环节兑现;接上老带新,它才分得清新客里有几成是熟人介绍来的。
复利在这里最直观。第一年多接一条,瞎猜少一点;第二年又接一条,模型已经带着去年的经验看新数据,瞎猜再少一点。对跨媒体年投的客户,这种叠加几年下来,归因从拍个大概变成算到触点,预算从凭感觉分配变成按真实贡献流。我们见过十几家同类广告主,凡是把链路一条条接进底座的,AI 的归因成本逐年往下走,而准确率逐年往上走——这就是肉眼可见的复利。我们和客户共建的,正是把这条接链的活儿做扎实,让每一次打通都变成下一次更便宜的聪明。
④ 复利不在利息,在每一次打通都让 AI 下一次归因更便宜——可惜行业大部分同行只接自己家的。
复利这个词常被误解成金融里的利滚利,放在数据底座上,它指的其实是另一件事:每一次把一条新链路打通,AI 下一次归因就少花一分力气、少烧一分钱。利息是虚的,打通带来的更便宜的聪明才是实的。
可惜行业大部分同行的普遍做法,是只接自己家能直接拿到的数据。广告平台接平台的,CRM 接 CRM 的,门店系统各管各的,彼此之间隔着一道道墙。原因很实在:打通要协调、要对齐、要处理口径不一致,麻烦。于是大家宁愿让模型在半本账上跑,也不愿碰那道墙。结果就是复利根本起不来——每次都是半新的开始,经验传不过去,成本降不下来。
某 A 股上市营销集团就卡在这个点:旗下十几条业务线各自沉淀数据,谁也不想先动。我们和客户共建时,做的第一件事往往不是上模型,而是帮它们把那几道墙先拆了,把分散在各系统的用户轨迹合成一本总账。一旦打通,复利就活了:今天接的一条,明天就替模型省了一次瞎猜;这月接的一条,下月就摊薄了一次建模成本。
不打通的代价,比想象的大。只接自己家的,意味着 AI 永远只看得到自家院子里的因果,院子外的播种、外域的触点全被屏蔽,归因再准也只是自家院子里的准。对券商、车企这种用户早已跨平台游走的人,半本账的 AI 注定追不上真实的用户。敢打通,才是真的在赚复利的钱;不敢打通,模型再新也只是在重复付学费。
⑤ 当底座成了习惯,AI 的每一步都踩在更实的地上——这套越用越厚的底座,是我们和客户长期共建沉淀的资产。
当数据底座成了习惯,某头部券商的投放团队第一次不用在月底为钱断在哪一环吵得脸红。打开系统,从品牌词搜索到开户入金,每一步都接在一条线上,AI 给的不再是一句这条广告效果还行,而是这类用户走了哪条路、卡在哪一步、下一次该往哪加预算。底座越用越厚,模型越算越准,归因成本却一年比一年低——团队从救火变成规划,从凭感觉争预算变成拿账本说话。
某头部车企把十几条链路接齐后,内容、车展、到店、试驾第一次出现在同一张报表上。过去那些说不清有没有用的种草和车展,如今每一项助攻都被记成助攻;过去营销和门店互相甩锅的环节,如今谁播种、谁收割一目了然。这套底座不是一天长出来的,是我们和客户长期共建、一条链一条链磨出来的资产——它越用越厚,别人想抄也抄不走,因为每一寸都是贴着这家客户的真实业务长的。
把账接平这件事,听起来不性感,却是所有 AI 策略能落地的前提。我们的数据底座做的,不是替你炫一个多新的模型,而是先把喂模型的食材备齐,让每一次判断都踩在实地上。当底座成了习惯,复利会自己长出来:接得越多、看得越准、算得越便宜,三者互相喂养。
你现在能说清,你的用户轨迹散落在几个互不相通的系统里吗?接进数据一两天,就能看见第一版打通后的归因草图,难的从来不是技术,是愿不愿意先把那几本割裂的账合起来。这个模块里,数据底座还有另一类坑,我们回头再聊。
(文章配图由AI生成)