本文内容源自对Matthew Prince的采访报道系列第三篇。
Prince的美国Cloudflare公司的联合创始人兼 CEO。
Cloudflare 你未必直接用过,但今天互联网上相当一部分网站背后都站着它。
它是全球规模最大的网络基础设施服务商之一,主营 CDN 加速、DDoS 防护、边缘计算和零信任安全。
2009 年创立,2019 年在纽约证券交易所上市(代码 NET)。
它最特殊的地方在于,每天处理数以万亿计的网络请求,相当于替大半个互联网当"门卫"和"流量枢纽"。
正因站在这个位置上,它对"网络流量里到底谁在活动"看得比谁都清楚——本系列文章中用到的那些吓人的流量数字,大多来自 Cloudflare 的一线观测。
Prince 本人是技术加法务的复合背景(本科毕业于芝加哥大学,后在哈佛法学院拿到 JD),2009 年与 Michelle Zatlyn、Lee Holloway 共同创立 Cloudflare。他说话不绕弯,近年来反复抛出一个判断:当机器人流量超过人类,整个建立在"人类注意力"之上的互联网商业逻辑,包括广告,都得重估。
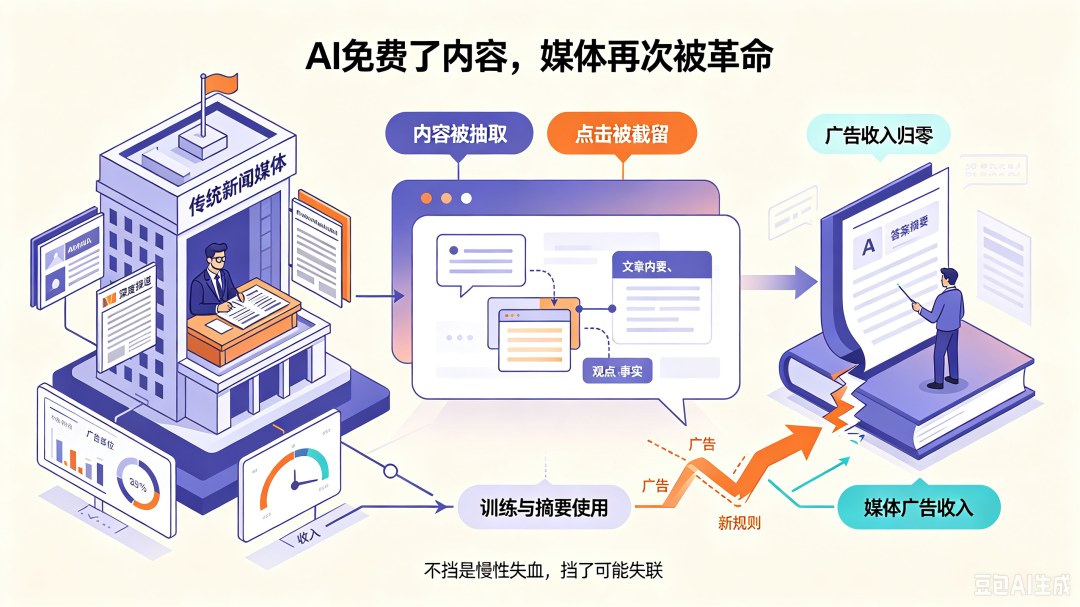
当你打开任何一个新闻网站,广告位撑起了过去二十年整个内容行业的饭碗。可现在,这个饭碗两头都开始漏。
一头是 AI 公司。它们几乎零成本地把全网的文章、报道、评论抓走,要么拿去训练模型,要么在用户提问时直接生成"答案摘要",把原本要点进网站才能看到的内容,截在了自己的对话框里。内容的生产者一分钱没拿到,内容的价值却被别人用掉了——这就是"内容白嫖"。
另一头是读者。当 AI 能一句话给出总结,很多人不再点开那篇深度报道。"我已经在 AI 那看过了"成了不点开链接的理由。可 AI 那句话的原材料,恰恰来自那篇没有点击的报道。
媒体真正的困境不是"被抄了",是"被抄了还断了流量"。 广告是按曝光和点击结算的,没人点进来,广告位就空着,收入就归零。
媒体被夹在中间
问题最棘手的地方在于,媒体几乎没得选。
不挡 AI 爬虫?那内容继续被免费吸走,读者越来越不过来,广告收入一路掉。挡了?又怕在 AI 的搜索结果和摘要里彻底消失——当越来越多人通过 AI 入口找信息,从 AI 那里"消失"几乎等于从互联网上"消失"。
这是个两难:不挡是慢性失血,挡了可能直接失联。不少出版商反映,AI 概览功能铺开之后,来自自然搜索的点击明显走低,而他们又不敢轻易把爬虫全挡掉,怕连这点引流也断掉。
媒体需要找到规则撑腰
自2026年9 月 15 日之后,Cloudflare 给新接入的、靠广告变现的页面改了默认规则:直接屏蔽"训练"类和"智能体"类的 AI 爬虫,只放行"搜索"类。等于在基础设施层面,替内容方把门看住了——AI 想拿广告页的内容去训练或填答案,得先谈条件。
这背后还有一条更大的线:AWS 在 2026 年 6 月推出 WAF 的 AI 流量变现功能,用 HTTP 402 状态码强制 AI 爬虫先付费再爬;IAB Tech Lab 在 2026 年 3 月发布 CoMP 规范,要求 AI 抓取内容前先建立商业协议;Taboola 走另一条路,把广告直接嵌进 AI 回答里跟出版商分钱。方向一致——内容的使用,不能再是免费的。
这不是某一家媒体的自救,是整个内容产业的收费层要重搭。
媒体的出路不在"挡",在"被需要"
把门看住只是第一步。真正能活下来的媒体,得想清楚一件事:当流量能被机器刷出来、被 AI 截断,你手里还剩什么别人拿不走的?
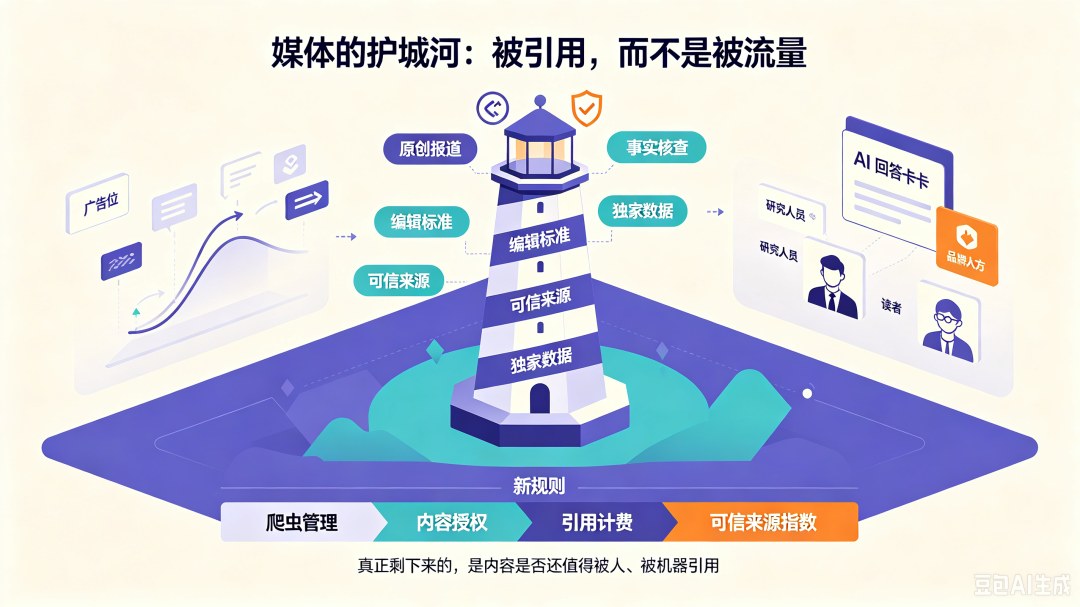
答案是内容本身的可信度。AI 再能编,也需要可信的来源喂它;读者再懒得点,遇到真要紧的事还是会找靠谱的出处。媒体的护城河,从来不是那个流量数字,是它生产的内容值不值得被"引用"。
★ 这一篇最该记住的: 媒体的护城河从来不是流量数字,是它生产的内容值不值得被"引用"。当流量能被机器刷出来、被 AI 截断,真正剩下来的是——你的内容,是否还被人、被机器当成可信的来源。
(文章配图由AI生成)